

Utku92
Bilgin
- Katılım
- 8 Şubat 2024
- Mesajlar
- 4.174
- Makaleler
- 1
- Çözümler
- 8
- Beğeniler
- 2.445


Önce Qwen 3.8-Flash-Next-GSQ-RCO-IQ3_S ve Abliterated modelini denedim. Sonrasında DeepSeek-V4.1-Flash-1017-GSQ-RCO-IQ2_XS ve Unsencered olan modelini denedim. İnanılmaz sonuçlar veriyor. Zaten yerelde 1. sırada DeepSeek olan modeli. Qwen'de 1M context ile 55 t/s aldım, hatta daha fazla da gördüm. DeepSeek'te yaklaşık 17 t/s gördüm. Bu 2 bit veya 3 bit olması kısmına takılmayın, adamların yaptığı sıkıştırma teknolojisi inanılmaz iyi koruyor. Modeli baya denedim, çok iyi sonuç aldım. Görselde de DeepSeek performansı görülüyor:
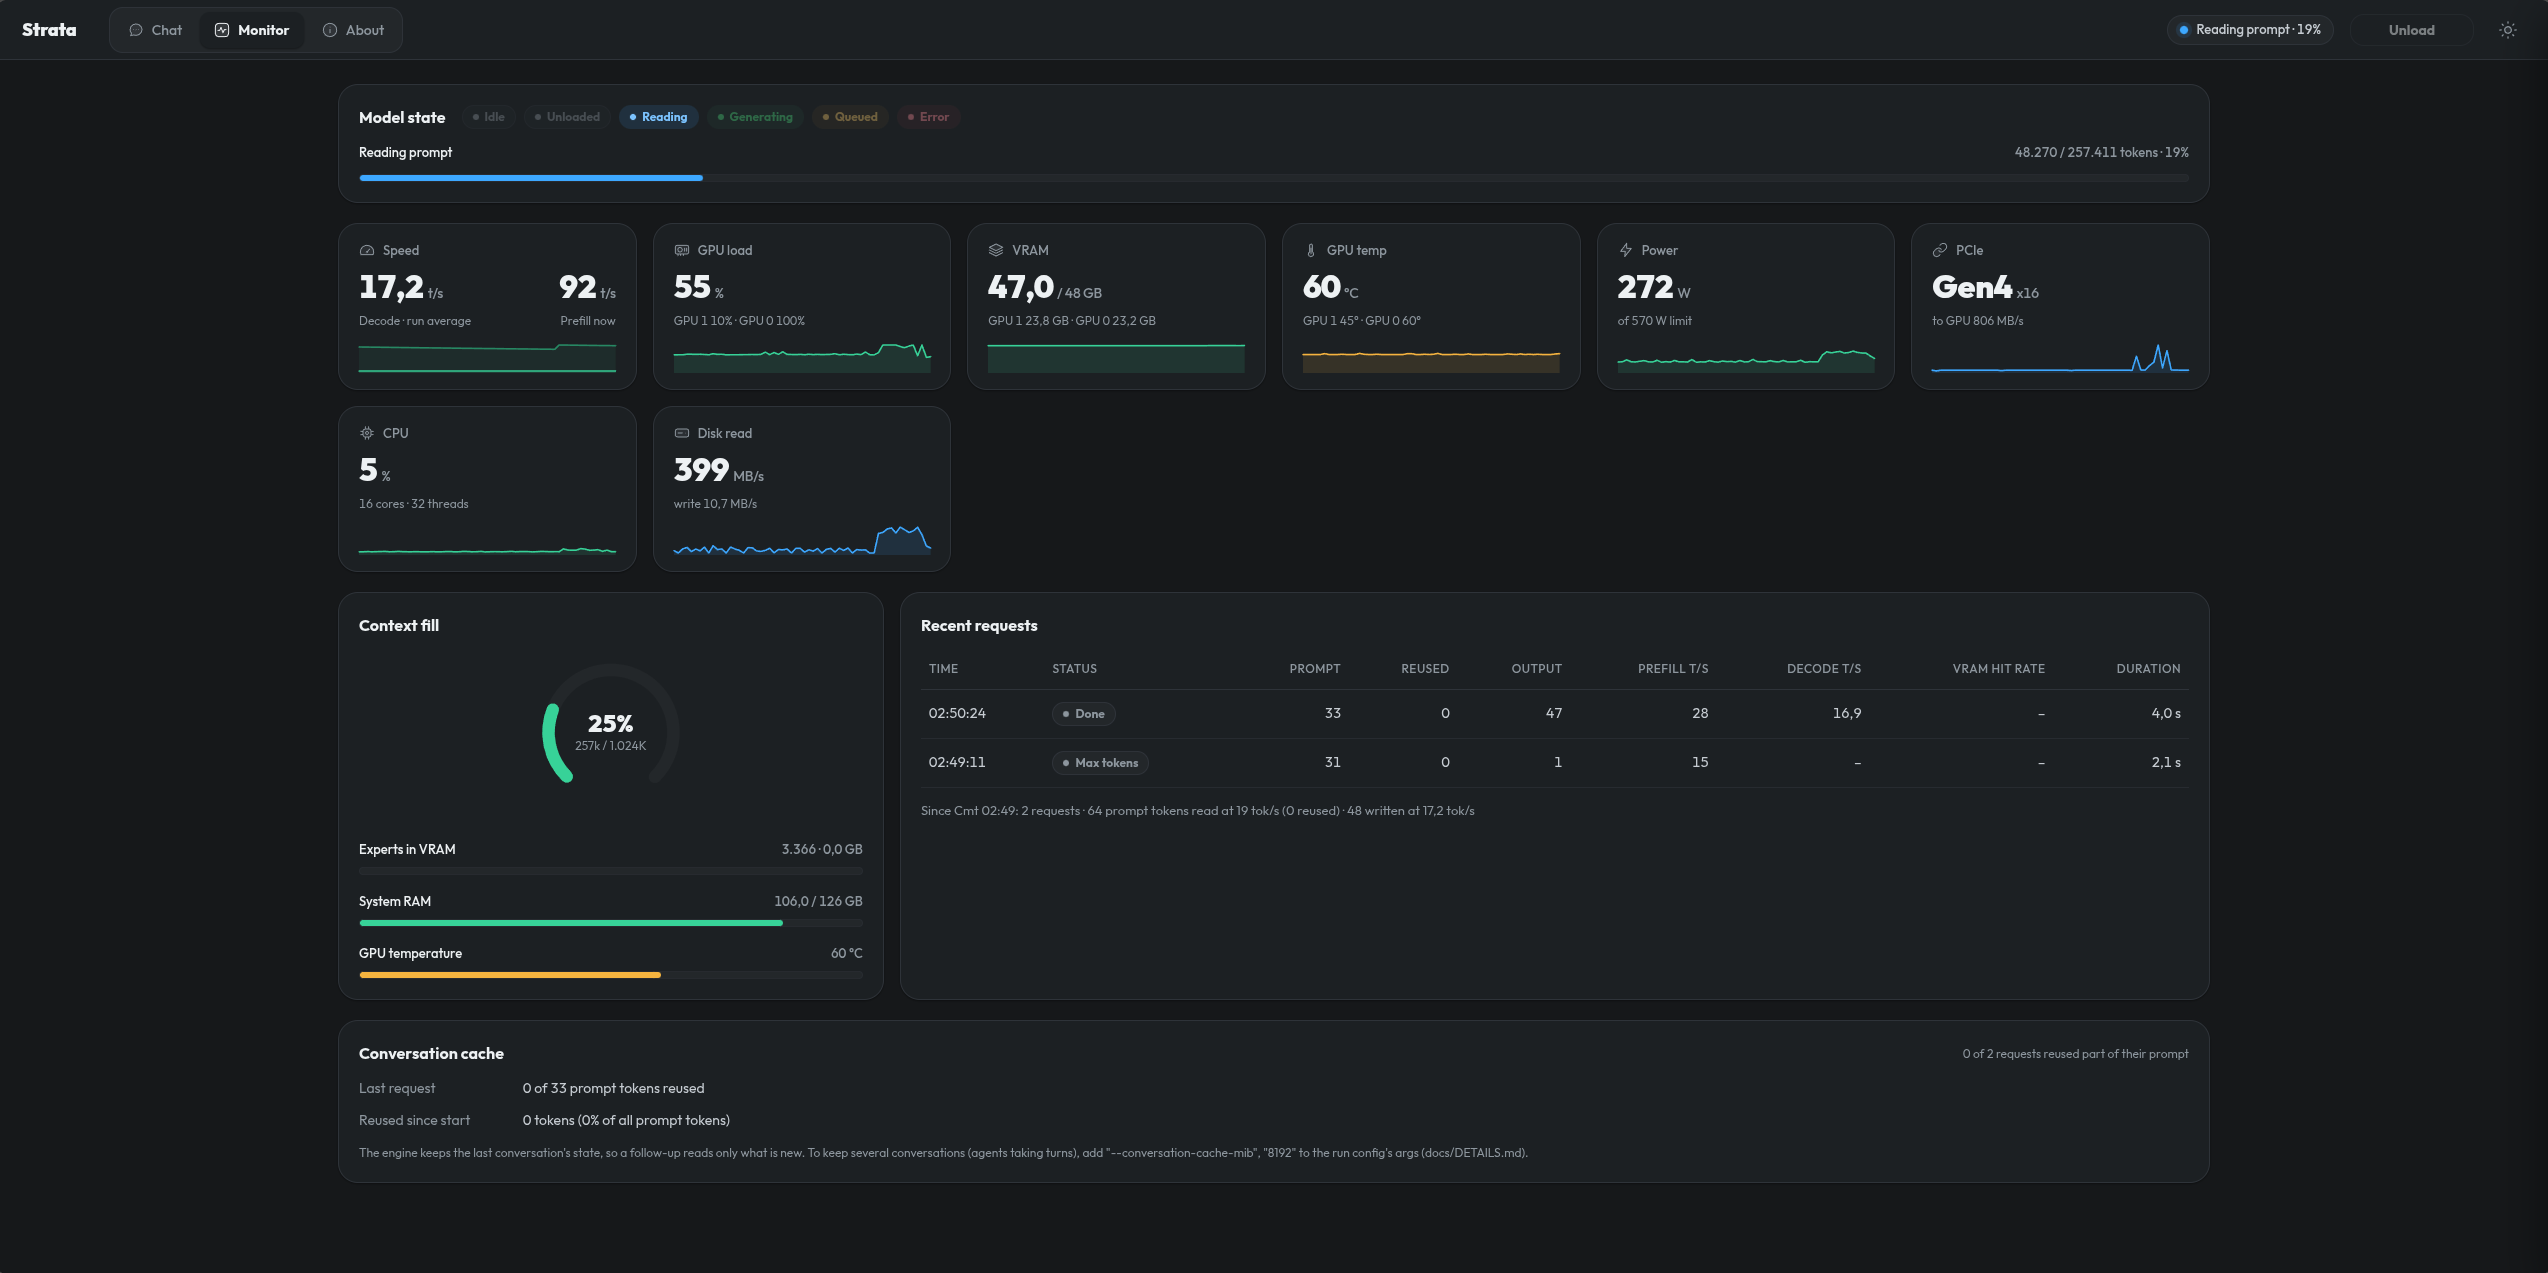
Anakartımın 2. slotu daha iyi olsa herhalde uçururdu tokenları.
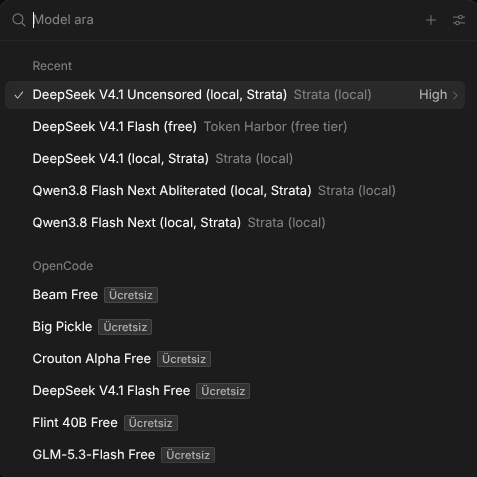
Burada da Opencode'a bağladığım kısım:
Anakartımın 2. slotu daha iyi olsa herhalde uçururdu tokenları.
Burada da Opencode'a bağladığım kısım:
Son düzenleyen: Moderatör:


